Tres preguntas y un punto de partida.
Empieza abajo
Ejemplo: extraer fecha, empresa e importe de una factura.
OpenAI · Model selection Luna Low: “Fine-grained edits, well-scoped problem-solving, and simple data extraction.”
Anthropic · Optimizing Haiku 4.5 “fits high-volume work with checkable outputs, not long agentic loops.”
Empieza en medio
Ejemplo: analizar un dataset para ver por qué cayó la conversión.
OpenAI · Model selection Sol Medium: “Everyday coding, research, and workflows that need judgment and completeness.”
Anthropic · Effort Sonnet 5 high (su default): “complex reasoning, coding, and agentic tasks where quality matters more than speed or cost”; medium es el paso de ahorro.
Empieza con capacidad
Ejemplo: entrar en un repo que no conoces, entender la arquitectura y diseñar una feature.
OpenAI · Models Para cuando no sabes por dónde empezar: “If you’re not sure where to start, use GPT-6 Astra, our flagship model for complex reasoning and coding.”
Anthropic · Models overview Para cuando no sabes qué modelo usar: “If you’re unsure which model to use, start with Claude Opus 5.5 for most workloads.”
Sube el techo
Ejemplo: un agente que trabaja muchas horas o una investigación muy larga.
OpenAI · Model selection Astra Extra high: “Demanding analysis and complex deliverables with exacting requirements.”
Anthropic · Models overview Fable 5.1 “for demanding reasoning and long-horizon agentic work, or when your evals on Claude Opus 5.5 at higher effort still fall short.”
Mídelo en vez de elegir a ojo
- Tareas reales y quality bar. Coge varias tareas que representen lo que haces y define qué significa que el resultado esté bien.
- Empieza capaz. Si no llega a la calidad, sube modelo o effort hasta que llegue. Antes de subir, revisa el prompt: en sus consejos para modelos de razonamiento, OpenAI pide tratar el effort “as a tuning knob, not the primary way to recover quality”.
- Baseline. Ya tienes una configuración que cumple. No es la final: es tu referencia.
- Optimiza. Baja el effort, prueba un modelo más eficiente y vuelve a ejecutar exactamente las mismas tareas.
- Óptima. La más barata que sigue pasando el quality bar.
Anthropic · Optimizing “…sweep two or three effort levels on a sample of your own traffic and read the answer off the curve.”
OpenAI · Model selection “Treat the guidance on this page as a starting point… keep the lightest setting that meets your quality bar.”
Abajo tienes la calculadora para comparar configuraciones y una plantilla para apuntar el proceso.
Qué effort usas sin saberlo.
Si no fijas el effort, el modelo usa su valor por defecto. En Claude es este (Claude API):
| Modelo | Effort por defecto | Nota |
|---|---|---|
| Claude Fable 5.1 | high | Sube a xhigh o max para lo más exigente. |
| Claude Opus 5.5 | medium | El punto de partida que recomienda Anthropic. |
| Claude Sonnet 5 | high | Medium es el paso de ahorro que propone la doc. |
| Claude Haiku 4.5 | no admite effort | Su razonamiento se regula con el presupuesto de thinking (extended thinking), o se cambia de modelo. |
reasoning.effort tú y así no dependes del default. Modelos de OpenAILeído el 25-09-2026 en Anthropic · Models overview. Haiku 4.5 se retira “not sooner than October 15, 2026”.
Coste por resultado correcto, no por token.
Un modelo más caro por token puede salir más barato por tarea: menos turnos, menos búsquedas, menos vueltas. Pon tus números: la calculadora no trae ninguna comparación de ejemplo, porque no hay una cifra general que valga para tu tarea.
Precios base por millón de tokens leídos el 25-09-2026 (Anthropic, OpenAI), editables. Sin caché, batch ni recargos por contexto largo. El effort cambia los tokens de salida y el % de acierto: mídelos con tus tareas.
Tu tarea recurrente, apuntada.
Se guarda en este navegador. Exporta a markdown para llevarlo a tu repo o a tus notas. No escribas datos personales ni claves.
La guía en una imagen.
La misma guía en vertical, para guardarla en el carrete.
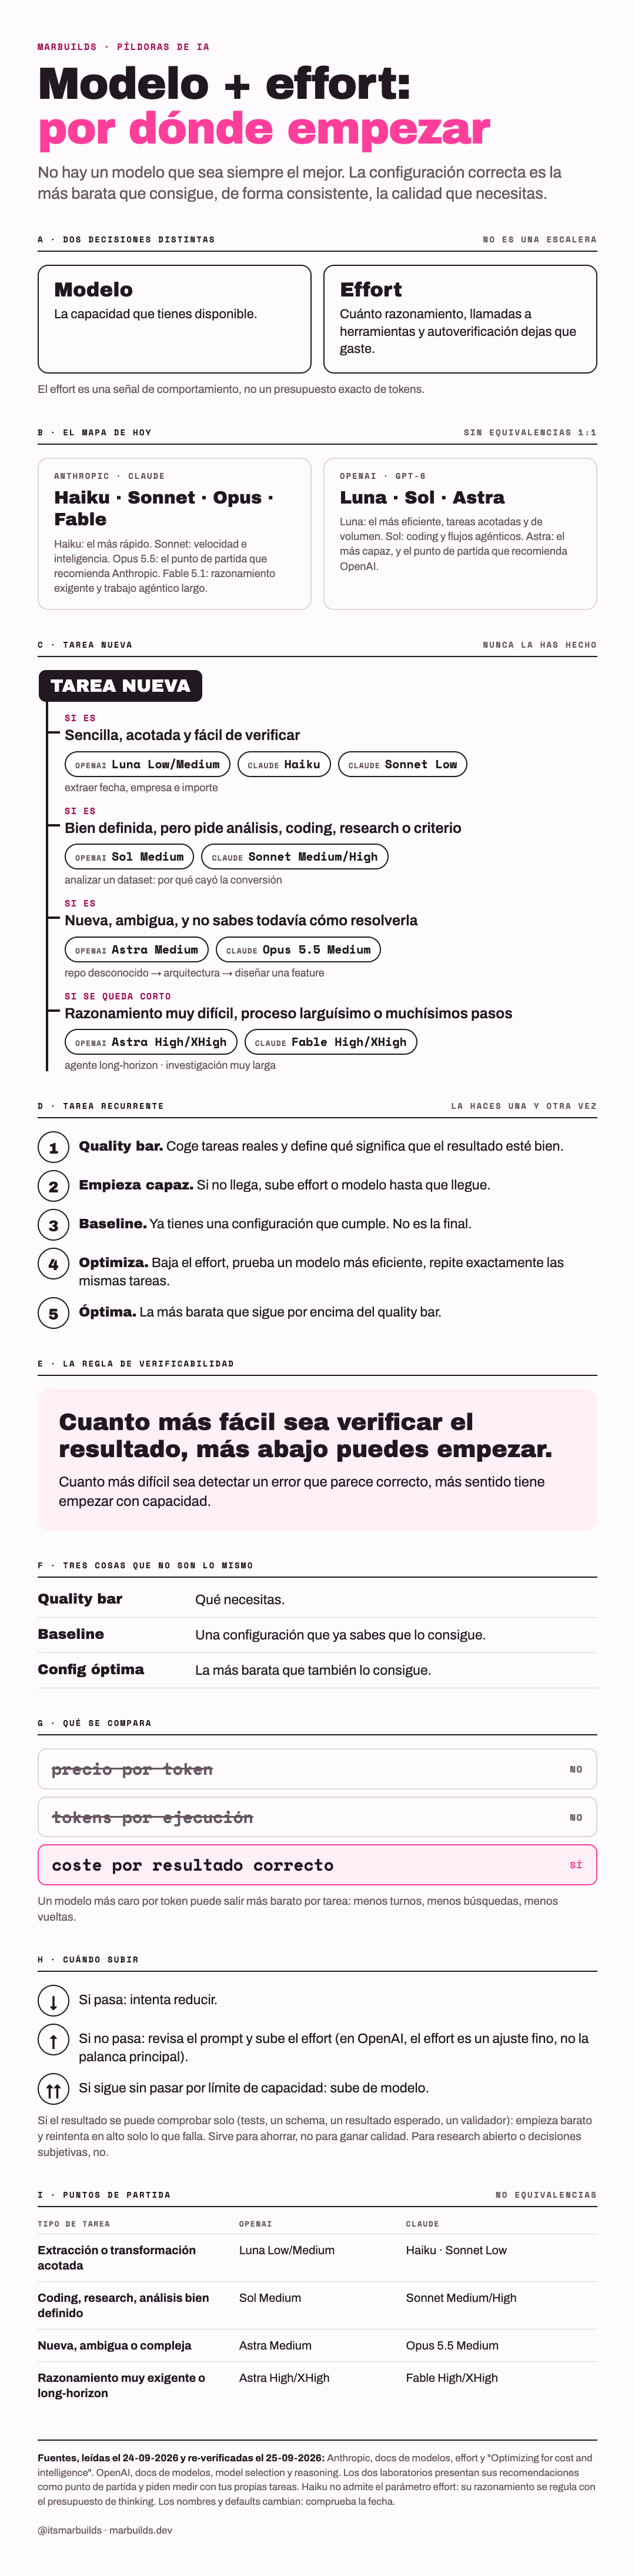
Todo sale de la documentación oficial.
Anthropic · Models overview · Anthropic · Effort · Anthropic · Optimizing for cost and intelligence · OpenAI · Models · OpenAI · Model selection · OpenAI · Reasoning
Leídas el 24-09-2026 y re-verificadas el 25-09-2026. Los dos laboratorios presentan sus recomendaciones como punto de partida y piden medir con tus propias tareas. Los nombres, precios y defaults cambian: mira la fecha.
@itsmarbuilds · Más recursos